
RAG • AGENTI
RAG, fine-tuning e agenti
Dare conoscenza all'AI locale
Guida: Intelligenza Artificiale Locale › RAG e personalizzazione
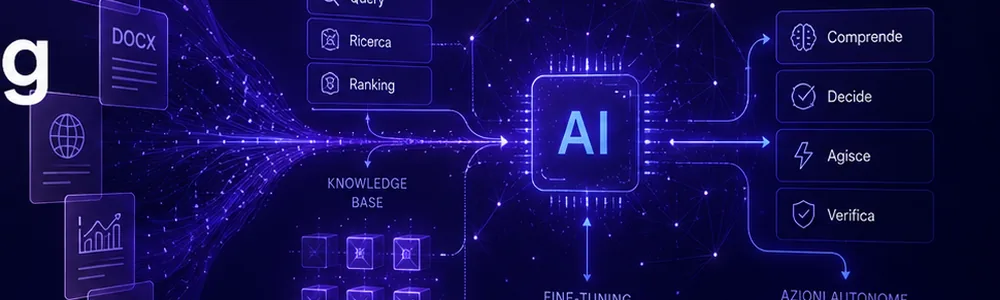
Per usare documenti aziendali con un LLM locale conviene distinguere RAG, fine-tuning e strumenti esterni. Il RAG recupera passaggi pertinenti da una base documentale e li inserisce nel contesto della risposta; il fine-tuning modifica il comportamento del modello tramite addestramento aggiuntivo e non sostituisce automaticamente una knowledge base aggiornata. Gli agenti possono eseguire azioni, ma richiedono autorizzazioni esplicite e controlli sui risultati.
Il prompt di sistema: la leva più semplice e sottovalutata
Il primo livello è definire istruzioni e criteri di risposta verificabili. Per una ricerca documentale servono poi una pipeline di acquisizione, permessi per documento, indicizzazione, retrieval e valutazione delle citazioni. La qualità va misurata su domande reali: un sistema può restituire un brano pertinente ma trarne una conclusione errata. Prima di collegare strumenti di scrittura o sistemi gestionali, considera i rischi operativi.
Cosa mettere in un prompt di sistema efficace: un’identità chiara (“sei l’assistente di…”), la lingua e il tono (“rispondi in italiano, in modo cordiale e conciso”), l’ambito (“sei competente su… non rispondere su argomenti non pertinenti”), le regole di comportamento (“se non sai qualcosa, dillo invece di inventare”), ed eventualmente informazioni stabili che vuoi sempre disponibili (orari, contatti, politiche). Come visto, in Ollama lo cuci dentro un modello personalizzato con il Modelfile, così non devi ripeterlo a ogni richiesta. In Open WebUI lo imposti dall’interfaccia. Spesso un buon prompt di sistema, abbinato a un RAG ben fatto, è tutto ciò che serve per un assistente professionale. Non sottovalutarlo: molti problemi che le persone cercano di risolvere con tecniche complesse si risolvono con un prompt scritto bene.
RAG in profondità: dare al modello i tuoi documenti
Il RAG (Retrieval-Augmented Generation, generazione aumentata dal recupero) è la tecnica che ti serve nella stragrande maggioranza dei casi per dare conoscenza al modello, ed è anche la più pratica. Premessa fondamentale, già anticipata: il modello non impara conversando. Quando la chat finisce, non ricorda. Per dargli conoscenza stabile serve una tecnica apposita, e il RAG è quella giusta quasi sempre.
L’idea, in chiaro
Invece di “infilare” la conoscenza dentro il modello (che richiederebbe il fine-tuning), gli dai i documenti da consultare al momento giusto. Il modello non “sa” le tue cose: le legge al volo ogni volta che servono. È la differenza tra imparare a memoria un manuale e tenerlo aperto sulla scrivania per consultarlo quando serve. La seconda via è più flessibile, più aggiornabile, e meno soggetta a errori.
Come funziona, passo per passo
Il flusso del RAG ha due momenti: la preparazione (una tantum, da rifare solo quando i documenti cambiano) e l’interrogazione (a ogni domanda).
Preparazione. Prendi i tuoi documenti — manuali, listini, FAQ, contratti, qualunque cosa. Li spezzetti in pezzi gestibili (il chunking): non puoi dare al modello un manuale intero per ogni domanda, quindi lo dividi in blocchi, tipicamente di qualche centinaio di parole. Ogni pezzo viene trasformato in un embedding — una rappresentazione numerica del suo significato — tramite un modello di embedding (sezione 17). Questi embedding finiscono in un database vettoriale, un archivio specializzato che permette di cercare per significato invece che per parole esatte.
Interrogazione. Quando un utente fa una domanda, il sistema la trasforma anch’essa in embedding, cerca nel database i pezzi di documento il cui significato è più vicino alla domanda (il retrieval, recupero), li passa al modello insieme alla domanda, e il modello risponde basandosi su quei pezzi. Spesso si aggiunge un passaggio di reranking: un secondo modello riordina i pezzi recuperati per pertinenza, così quelli davvero rilevanti finiscono in cima. Il risultato è una risposta ancorata ai tuoi documenti, con la possibilità di citare le fonti.
I vantaggi, concreti
Aggiorni la conoscenza semplicemente cambiando i documenti, senza riaddestrare nulla: aggiungi un listino, rimuovi una FAQ obsoleta, e il sistema lo riflette subito. Il modello può citare le fonti precise. Il rischio che “inventi” sui tuoi dati cala drasticamente, perché li ha davanti agli occhi. E si fa con strumenti pronti, senza scrivere codice complesso.
Il chunking: l’arte spesso trascurata
Come spezzetti i documenti conta più di quanto sembri. Pezzi troppo grandi diluiscono il significato e sprecano contesto; pezzi troppo piccoli perdono il filo. La pratica sensata: blocchi di qualche centinaio di parole, con una piccola sovrapposizione tra blocchi consecutivi (così un concetto a cavallo di due pezzi non si perde), e rispettando per quanto possibile i confini naturali del testo (paragrafi, sezioni). Per documenti strutturati (tabelle, listini), strategie dedicate preservano la struttura. Un buon chunking è metà della qualità di un RAG: vale la pena curarlo.
Il database vettoriale: dove vivono gli embedding
I database vettoriali più usati in locale sono Chroma (semplice, leggero, perfetto per cominciare), Qdrant (più robusto e scalabile, ottimo per produzione), e pgvector (un’estensione di PostgreSQL, comoda se già usi quel database). Tutti girano in casa, in container Docker come il resto dello stack. Per la maggior parte delle esigenze, Chroma o Qdrant bastano e avanzano.
Costruire un RAG: la via semplice e la via su misura
La via semplice — Open WebUI. Open WebUI ha il RAG integrato: dall’interfaccia carichi i documenti (o intere cartelle), il sistema li spezzetta, li trasforma in embedding e li archivia, e da quel momento il modello risponde basandosi su di essi. Per moltissime esigenze interne — una base di conoscenza aziendale, i manuali, le procedure — questo basta, senza scrivere una riga di codice. Configuri il modello di embedding (per esempio nomic-embed-text o BGE-M3) nelle impostazioni, carichi i documenti, e hai un assistente che conosce la tua azienda.
La via su misura — i framework. Per esigenze più strutturate o per integrare il RAG nelle tue applicazioni, ci sono framework dedicati: LlamaIndex (pensato apposta per il RAG, gestisce ingestione, indicizzazione e recupero con poche righe) e LangChain (più ampio, orchestrazione di flussi complessi). Soluzioni “tutto in uno” come AnythingLLM offrono un’interfaccia pronta per RAG su documenti con gestione utenti. Con questi costruisci pipeline che recuperano dai tuoi documenti e si integrano nel sito, in un gestionale, ovunque.
Il consiglio che vale oro
Per il RAG, la qualità del recupero conta più della taglia del modello linguistico. Un buon modello di embedding, uno spezzettamento pulito, un database ben organizzato e un eventuale reranking, abbinati a un modello anche medio, battono un modello gigante con un recupero fatto male. Non ti serve la macchina più potente per un ottimo RAG: ti serve farlo bene. Investi tempo nel chunking e nella scelta dell’embedding più che nell’inseguire il modello linguistico più grosso.
Fine-tuning: potente, ma raramente necessario
Il fine-tuning è l’altra strada per dare conoscenza o, più propriamente, comportamento al modello: riaddestrarlo davvero su dati tuoi, modificandone i parametri interni perché si specializzi. È la tecnica giusta quando vuoi cambiare in profondità lo stile, il tono, il modo di rispondere, o insegnargli un compito molto specifico che il RAG non copre. Per dargli semplicemente informazioni, invece, il RAG è migliore e più semplice: il fine-tuning serve quando vuoi che il modello si comporti diversamente, non solo che sappia di più.
Nel 2026 il fine-tuning si fa quasi sempre in forma “leggera”, con tecniche come LoRA e QLoRA, che addestrano solo una piccola parte del modello invece di tutto, rendendolo fattibile anche su hardware da workstation (fasce 4-5) invece che su cluster. Esistono strumenti che semplificano molto il processo: Unsloth (efficiente, veloce, popolare per il fine-tuning su singola GPU) e Axolotl (flessibile, ricco di opzioni). Serve però un dataset di qualità, costruito con cura — esempi del comportamento desiderato, formattati correttamente, in quantità sufficiente — e una certa competenza. È un progetto, non un comando: si pianifica, si prepara, si verifica.
La regola pratica onesta: comincia sempre dal RAG e dal prompt di sistema. Insieme risolvono quasi tutto, costano poco, li aggiorni in tempo reale. Passa al fine-tuning solo se, dopo aver fatto bene il RAG, ti accorgi che ti manca davvero qualcosa che solo un cambio di comportamento profondo del modello può dare. Per un assistente di bottega, un chatbot di sito, un supporto interno, il RAG e un buon prompt sono quasi sempre la risposta completa. Il fine-tuning è uno strumento potente da tenere nella cassetta degli attrezzi, ma non è il primo che prendi in mano.
Agenti e tool use: dal “consulente che parla” al “collega che fa”
Finora abbiamo un assistente che risponde. La frontiera del 2026 sono gli agenti: sistemi che non si limitano a rispondere, ma ragionano, decidono ed eseguono azioni concrete. La differenza è enorme: un assistente ti dice come fare una cosa; un agente la fa.
Il tool use: dare strumenti al modello
Il meccanismo si chiama tool use (uso di strumenti) o function calling (chiamata di funzioni). In pratica, dai al modello una serie di “strumenti” che può usare — interrogare un database, cercare sul web, leggere un file, scrivere su un sistema, mandare una email, controllare il magazzino — e il modello, quando serve, decide di usarli e ne interpreta i risultati. Tu chiedi “quanti pezzi del prodotto X abbiamo in magazzino e quando arriva il prossimo carico?”; il modello capisce che deve interrogare il gestionale, lo fa tramite lo strumento che gli hai dato, riceve i dati e ti risponde con i numeri reali. Non è più un modello che “sa” cose vaghe: è un modello che agisce sui tuoi sistemi.
Non tutti i modelli sono ugualmente bravi con gli strumenti: alcuni (le famiglie Qwen, Llama, Mistral) gestiscono il tool use in modo affidabile; altri sono più deboli. Quando l’obiettivo è costruire agenti, scegli modelli noti per il buon supporto al function calling.
MCP: lo standard per collegare i modelli al mondo
Sta emergendo uno standard per collegare i modelli agli strumenti e ai dati in modo pulito e riutilizzabile: l’MCP (Model Context Protocol). Invece di costruire ogni integrazione da zero, l’MCP definisce un modo standard perché un modello acceda a strumenti, file, servizi. È il “connettore universale” che permette di collegare l’assistente al gestionale, al calendario, alla posta, ai documenti, in modo modulare. Per chi costruisce sistemi seri, è la direzione su cui investire: rende le integrazioni componibili invece che artigianali ogni volta.
Cosa significa in pratica per te
Per un’attività, gli agenti aprono scenari concreti: un assistente che non solo risponde sui prodotti ma controlla davvero il magazzino e prende ordini; un sistema che legge le email in arrivo, le classifica, prepara le risposte; un agente che, dato un compito, interroga più sistemi, mette insieme i dati e produce un report. È il salto da “assistente che parla” a “collega digitale che fa”. La tecnologia nel 2026 è ancora in maturazione — gli agenti vanno progettati con cura e con i giusti controlli, perché un sistema che agisce va supervisionato più di uno che solo risponde — ma la direzione è chiara, ed è probabilmente la trasformazione più importante dei prossimi anni.
Costruire un assistente vocale completo
Mettendo insieme i pezzi della sezione 18, ecco come orchestrare un vero assistente vocale che gira interamente in casa. La pipeline ha tre stadi, ognuno locale.
Primo stadio, ascolto: l’utente parla, e Whisper (via whisper.cpp, faster-whisper o un server come Speaches) converte la voce in testo. Secondo stadio, ragionamento: il testo va al modello linguistico tramite Ollama, che — con il suo prompt di sistema, l’eventuale RAG sui tuoi documenti e gli eventuali strumenti — elabora la risposta. Terzo stadio, voce: la risposta testuale va a Kokoro o Piper, che la converte in voce naturale.
Il flusso, concettualmente: voce → Whisper → testo → modello (Ollama) → testo → Kokoro/Piper → voce. Tutto in container Docker sulla stessa macchina, tutto in rete locale, niente che esca. Lo strumento Speaches semplifica i due stadi audio in un solo server compatibile con le API di OpenAI, con supporto a conversazioni bidirezionali in tempo reale, lasciandoti orchestrare il dialogo con il modello. Su una macchina con GPU da 24 GB e un modello MoE da 20-30 miliardi, l’intero giro — parli, capisce, ragiona, risponde a voce — avviene in uno-due secondi, paragonabile agli assistenti commerciali, ma con un vantaggio decisivo: è tuo, privato, lo chiami come vuoi, gli dai la personalità che preferisci, e nessuno ascolta le tue parole. Per un negozio, un ufficio, una casa, è l’assistente vocale che fa quello che Alexa e gli altri fanno, senza il prezzo nascosto della tua privacy.
Un’avvertenza realistica: l’assistente vocale locale è ottimo per comandi, domande, dettatura, interazioni strutturate; la qualità della voce sintetica, pur buona, non sempre eguaglia il meglio del cloud commerciale, e gli agganci a servizi esterni in tempo reale (meteo da API, ordinare qualcosa online) richiedono integrazioni apposite. Ma per il cuore dell’esperienza — capire cosa dici e risponderti in modo utile, privato e immediato — nel 2026 il locale c’è.
← ModelliProduzione e sicurezza →
Vuoi la tua AI privata, accesa e funzionante?
In Terabyte Lab progettiamo, assembliamo e configuriamo la macchina su misura: hardware, modello, RAG, voce e sicurezza, pronti all'uso.